把claude的子代理换Haiku 5.5:单价差40倍还少脑补

读完这篇你会知道把 Claude Code 的子代理换成 Haiku 5.5 单价差多少、质量会不会缩水,以及它为什么没有变快。全文大约需要读 3 分钟。
换成 Haiku 5.5,单价差 40 倍
我把 Claude Code 的子代理换成 Haiku 5.5,按官方基础单价,Haiku 只有 Opus 的 1/40,而且实测下来不仅没翻车,脑补反而更少了。
Anthropic 在 10 月 7 日前后发布了 Claude Haiku 5.5(claude-haiku-5-5)。官方标价是单次提示 10 万 token 以内输入 $0.10、输出 $0.50 每百万,超过 10 万 token 变成 $0.50 / $2.50;默认的 Opus 5.5 是输入 $4、输出 $20 每百万,单价正好差 40 倍。
在 Claude Code 里,我把一份包含 52 个 AI 博主名单的 CSV 切成了 5 份,开 5 个子代理并行跑,每个子代理读一份数据,最后输出「每个号值得学什么」的表格和 3 条要点。同一个提示词跑了三组,每组跑一次:A 组是默认模型 Opus 5.5;B 组把子代理指定为 Haiku 5.5;C 组是 Haiku 5.5 加上 effort low。


耗时与用量:小模型居然没变快
三组 5 个子代理消耗的总 token 都在 25 万左右,其中 A 组 24.4 万、B 组 25.4 万、C 组 24.8 万,大部分用量都是系统提示词和读入的文件。三组用的 token 量差不多。但我只拿到了总 token 数,没有输入、输出、缓存的分项,所以实际账单或订阅额度能省多少,这次没有测出来,只能说单价差 40 倍。
但平均耗时完全出乎我的意料。A 组默认模型耗时 14.0 秒,B 组换成 Haiku 5.5 反而跑了 18.2 秒,只有 C 组加了 effort low 跑出 12.9 秒,比默认快了一点点。拆开看 B 组的 5 批任务,其中有 2 批直接飙到了 22.6 秒和 24.9 秒,另外 3 批才和默认差不多,在 14.0 到 14.7 秒之间。因为只测了一次,中间肯定有网络和排队波动的影响。
小模型不等于更快。这种任务的耗时大头都在读入文件和等待排队上面,模型本身那点生成速度的差距直接被盖住了。如果不调 effort,单纯换成 Haiku 5.5 并不能帮你省时间。
质量逐条人工核对:Haiku 甚至更老实
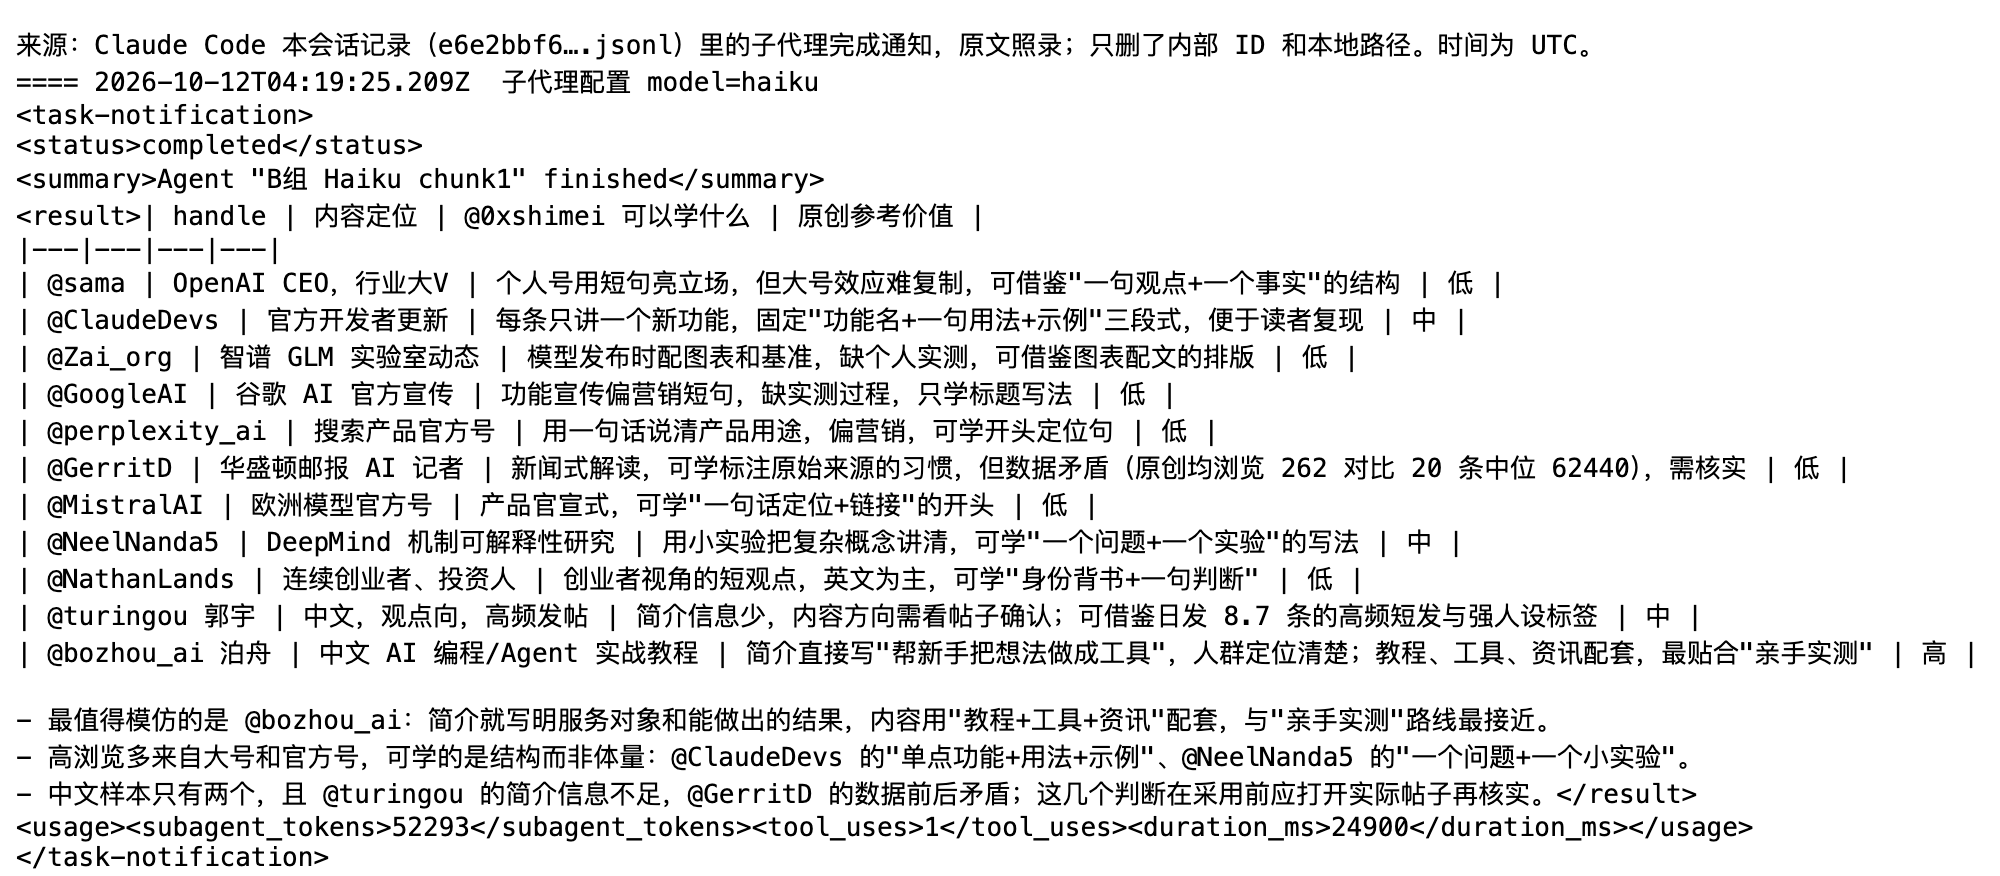
为了看质量有没有缩水,我把输出结果逐条对照原始数据做了人工检查。默认模型的建议写得更具体,拿过来就能直接用,但有个坏毛病就是会脑补。名单里有个博主简介只有「。。。」三个句号,默认模型直接脑补成「中文技术大V」。
换成 Haiku 5.5 之后明显谨慎得多。遇到这种空简介,它老老实实写「需人工确认」,绝不瞎编。甚至它还主动挑出了数据毛病:指出名单里有个号「原创均浏览 262、中位浏览 62440」前后矛盾,我回去查原始数据,发现当时抓取出来的数据确实不对。
另外在算比例上它也没掉链子。Haiku 算出来的几个数字,比如浏览是粉丝的 41 倍、0.88 倍,我人工核算了一遍全部正确。C 组虽然调了 effort low,输出质量和 B 组基本没有差别。
怎么在 Claude Code 里换模型
改配置其实很简单,根本不需要复杂折腾。第一种方式是在子代理的定义文件里,直接写上 model: haiku。
第二种方式是启动时带上环境变量:CLAUDE_CODE_SUBAGENT_MODEL=claude-haiku-5-5 claude。注意它只是默认值,子代理定义里或调用时写了 model 的,以写的为准。另外官方 2.1.296 的更新日志新增了 CLAUDE_CODE_WORKFLOW_SUBAGENT_MODEL,可以给 workflow 里的子代理统一指定模型。

我的建议/什么时候用哪个
测完这三组,我给出几条明确的搭配方案,大家可以按需求分工:
- 读文件、整理表格、批量打标签、数据初筛 → Haiku 子代理(要快就加 effort low)
- 需要判断、写方案、对外输出的那一步 → 留给主模型
- 子代理结果要人工抽查:它会更老实地标出「不确定」,别把这些标记删掉
你在跑子代理做批量脏活的时候,更愿意相信大模型自己脑补的方案,还是相信小模型留下的「不确定」?